難解なイェンゼンの不等式を完全解剖!機械学習と統計学を支える本質
数理統計学や機械学習の専門書を開くと、必ずと言っていいほど重要な局面で立ちはだかるのが「イェンゼンの不等式(Jensen's inequality)」です。一見すると抽象的な数式が並んでいるだけに思えますが、2026年の最先端生成AIやデータサイエンスの現場において、この不等式は極めて強力な「理論的支柱」として君臨しています。
デンマークの数学者ヨハン・イェンゼンが体系化したこの定理は、なぜ時代を超えてこれほど重宝されるのか。統計検定1級での出題傾向から、現代AIの心臓部である変分自己符号化器(VAE)やEMアルゴリズムの裏側まで、直感的な幾何イメージと証明の勘所を編集部の視点から徹底的に解き明かします。
📌 【この記事の重要ポイントまとめ】
- 要点1:「凸関数の期待値は、期待値の関数値以上になる」という幾何学的な直感が定理の根幹であり、グラフ上の弦と重心の位置関係だけで直感的に理解できる。
- 要点2:相加相乗平均の一般化からKLダイバージェンスの非負性、EMアルゴリズムや変分推論における変分下限(ELBO)の導出まで、最先端AIの最適化計算の土台を担う。
- 要点3:凸と凹の反転による符号ミスが初学者の最大の落とし穴であり、数学的帰納法と等号成立条件を押さえることで試験対策から実務実装まで迷いが消える。
【本質直観】なぜ「イェンゼンの不等式」は難解に見えるのか?幾何学的イメージと基本公式
多くの学習者がイェンゼンの不等式に対して苦手意識を抱く最大の理由は、記号の抽象性にあります。しかし、その根底にあるのは極めてシンプルな凸関数の性質と重心のバランス関係に過ぎません。
まず、基本となる数式を確認してみましょう。実数上の区間で定義された下に凸な関数 $f(x)$ と、その区間に値をとる確率変数 $X$ に対し、期待値が存在するとき、次の関係が必ず成立します。
$f(E[X]) \le E[f(X)]$
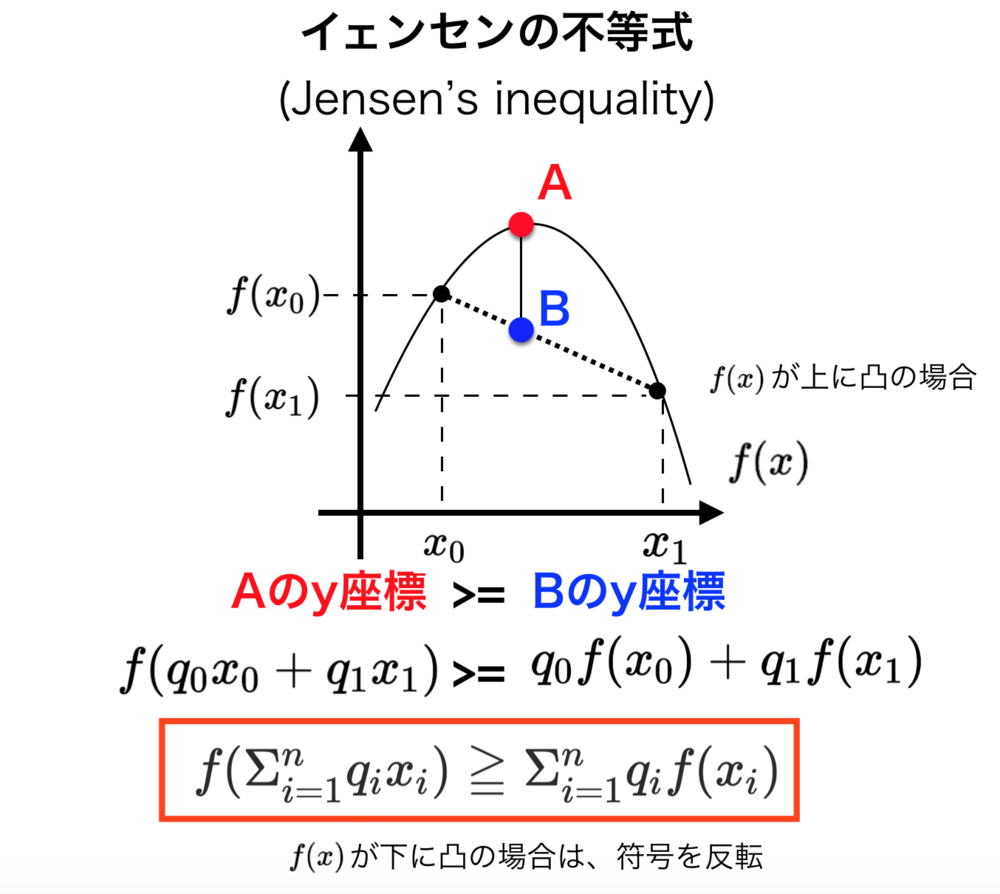
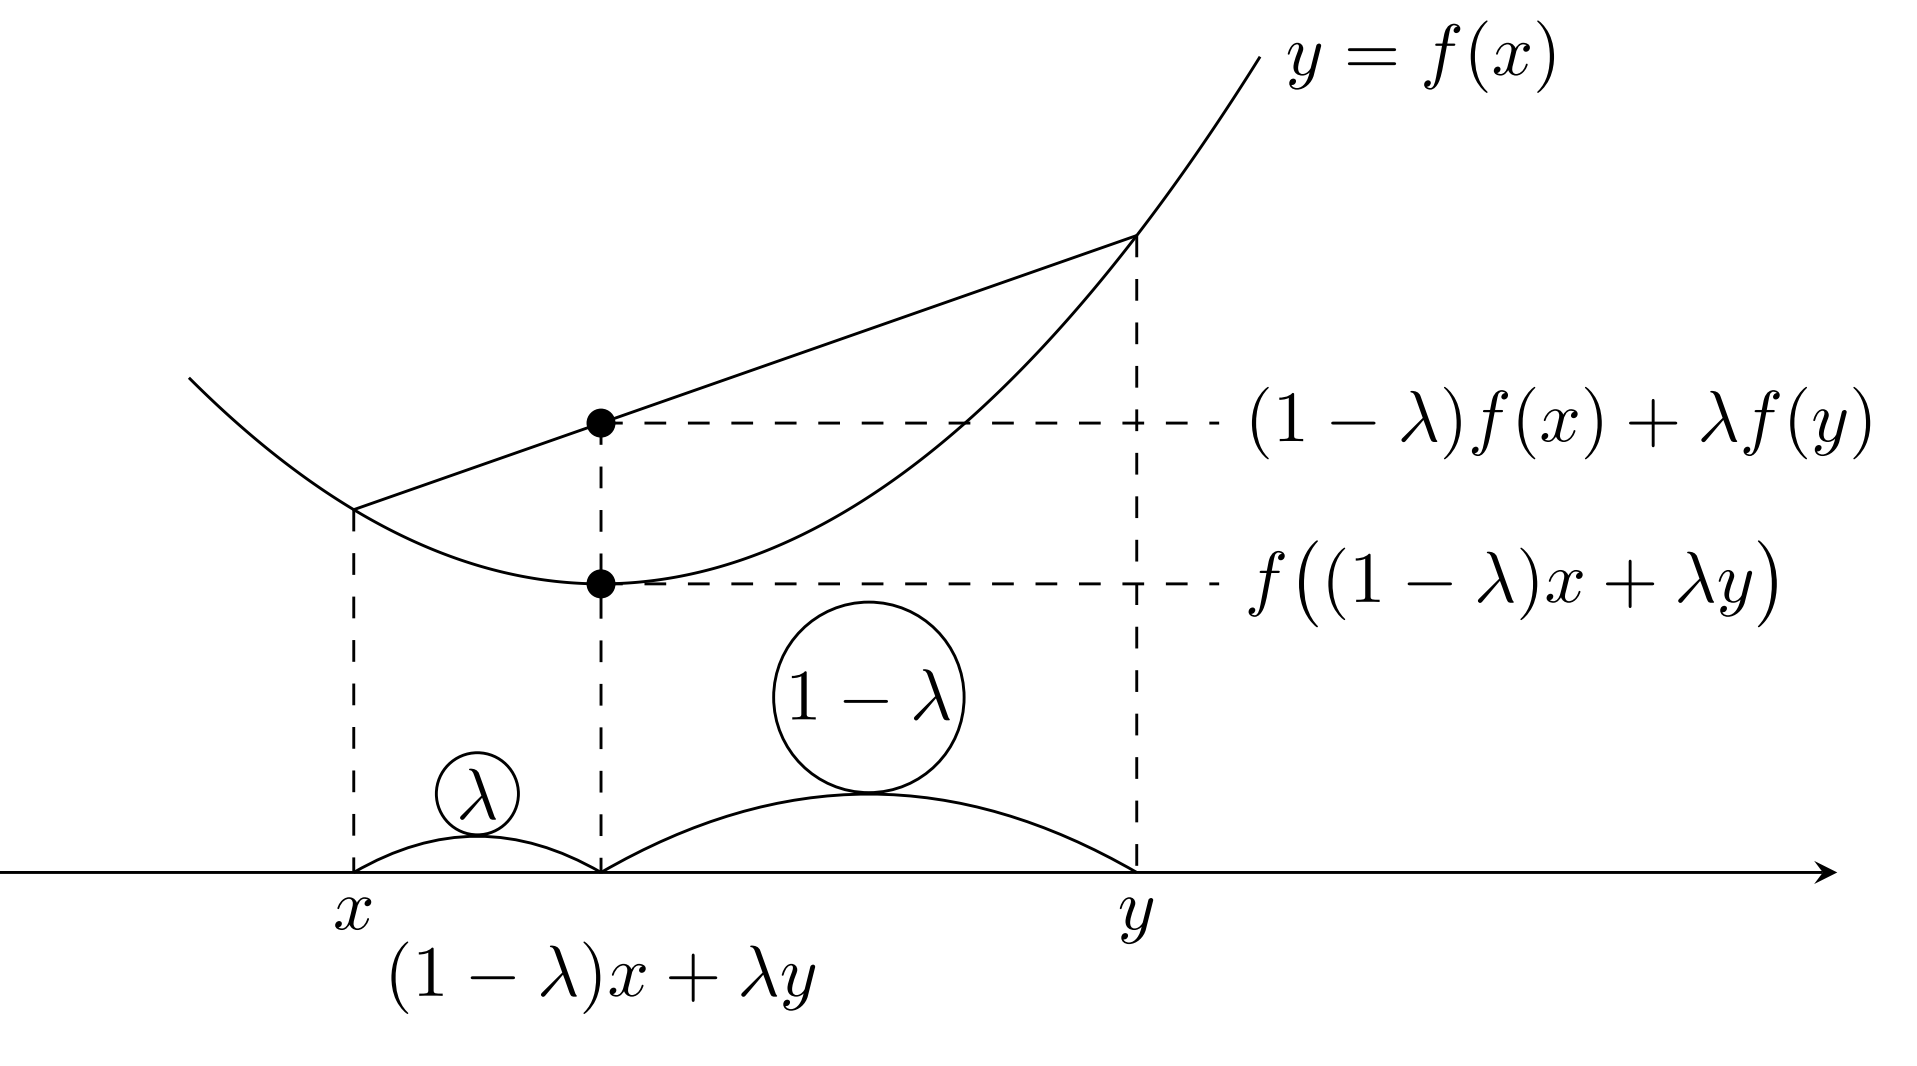
この数式を読み解く鍵が、直感的な幾何学的イメージです。関数 $f(x) = x^2$ のような「下に凸(convex)」な放物線を思い浮かべてください。曲線上の任意の2点 $A(x_1, f(x_1))$ と $B(x_2, f(x_2))$ を線分(弦)で結ぶと、2点の間にある曲線の部分は必ず弦よりも下側に位置します。
ここで、2点の間で重み $1-p$ と $p$(ただし $0 \le p \le 1$)で内分する点を考えます。この内分点こそが確率論における「期待値」です。$x$ 軸上で内分してから関数の高さを測った値 $f(p x_1 + (1-p)x_2)$ は、グラフの高さを内分した値 $p f(x_1) + (1-p)f(x_2)$ よりも常に下、あるいは一致します。これを一般の確率分布に拡張したものが、まさにイェンゼンの不等式です。
この幾何学的事実は、確率論の基礎における最も身近な指標である期待値と分散の関係にも綺麗に表れています。関数として下に凸である $f(t) = t^2$ を適用すると、不等式は次のようになります。
$(E[X])^2 \le E[X^2] \iff E[X^2] - (E[X])^2 \ge 0$
この左辺引き算の結果は、分散 $Var(X)$ そのものです。つまり「分散が常に0以上である」という当たり前の統計的事実すら、イェンゼンの不等式が内包する美しい必然性の一片に過ぎません。
【証明の手順】数学的帰納法から確率変数への拡張までつまずきポイントを完全攻略
イェンゼンの不等式の証明は、基礎から段階を踏めば驚くほど整然としています。統計検定や大学の数理統計試験でも頻出となる「つまずきやすい論理ステップ」を、2つのアプローチから整理します。
アプローチ1:数学的帰納法による離散確率変数の証明
最も直感的で試験でも再現しやすいのが、標本点が有限個($n$ 個)の離散分布を想定した数学的帰納法によるアプローチです。
【ステップ1:$n=1, 2$ での成立】
$n=1$ は自明です。$n=2$ の場合、下に凸な関数の定義そのものより、任意の $p_1, p_2 \ge 0$($p_1 + p_2 = 1$)に対して $f(p_1 x_1 + p_2 x_2) \le p_1 f(x_1) + p_2 f(x_2)$ が成り立ちます。
【ステップ2:$n=k$ での成立を仮定】
$\sum_{i=1}^k p_i = 1$ を満たす任意の非負の重みに対して $f\left(\sum_{i=1}^k p_i x_i\right) \le \sum_{i=1}^k p_i f(x_i)$ が成立すると仮定します。
【ステップ3:$n=k+1$ での検証】
$\sum_{i=1}^{k+1} p_i = 1$ のとき、$1 - p_{k+1} = \sum_{i=1}^k p_i$ と置き、全体を巧みに2項の形へ分解します。内分比率を調整して $n=2$ の性質を適用したのち、仮定である $n=k$ の関係を代入することで、$n=k+1$ でも不等式が保持されることがエレガントに示されます。
アプローチ2:接線(支持超平面)を用いた連続型確率変数への一般化
一方、任意の連続型確率変数や積分形を含む測度論的設定では、「接線」を用いた証明が圧倒的な切れ味を発揮します。
下に凸な微分可能関数 $f(x)$ のグラフは、任意の点 $c$ における接線よりも常に上側に位置します。点 $c$ における接線の方程式を考えると、すべての $x$ において次の関係が成り立ちます。
$f(x) \ge f(c) + f'(c)(x - c)$
ここで、$c$ として確率変数の期待値 $\mu = E[X]$ を選び、$x$ に確率変数 $X$ を代入して両辺の期待値をとります。期待値の線形性(加法性と定数倍の保持)により、右辺の第2項は次のように消失します。
$E[f'(E[X])(X - E[X])] = f'(E[X]) \cdot (E[X] - E[X]) = 0$
残る項を整理すると、たちどころに $E[f(X)] \ge f(E[X])$ が導出されます。この論法は、多次元空間における勾配や劣微分(subdifferential)を用いてもそのまま成立するため、機械学習の高度な最適化理論でも標準的に用いられる道具立てとなっています。
【比較検証】統計学・機械学習における主要応用分野と活用メリット一覧
イェンゼンの不等式は、単なる数理パズルではありません。情報科学の未解決問題を解き明かし、機械学習モデルが「解けないはずの複雑な計算」を近似的に実行可能にする原動力です。主要な応用領域と実務的なインパクトを下表にまとめました。
| 項目・応用先 | 詳細・活用される数理モデル | 一般的な基準・従来手法との差異 | 編集部の見解・実務評価 |
|---|---|---|---|
| 相加相乗平均の一般化 | 負の対数関数 $f(t) = -\log t$(凸関数)を適用し、重み付き相加相乗平均を即座に導出。 | コーシーの逆向き帰納法などに比べ、証明がわずか数行で完結する。 | 数理的美しさの極致。不等式評価の基礎体力を養う登竜門。 |
| 情報理論とKLダイバージェンス | 確率分布の隔たりを測る $D_{\mathrm{KL}}(P \parallel Q) \ge 0$(ギブスの不等式)の非負性を証明。 | 距離の公理を満たさない「擬似的な距離」が破綻しない数学的保証。 | 情報理論における役割は絶大。言語モデルの損失関数設計の前提。 |
| EMアルゴリズムの導出 | 観測データの対数尤度を潜在変数で周辺化する際、対数の内側に現れる和を下限(Q関数)で評価。 | 直接的な最尤推定が解析的に解けない混合ガウスモデル(GMM)等を解法へ導く。 | 不完全データ解析の金字塔。実務におけるクラスタリングの確固たる基盤。 |
| 変分推論と変分下限(ELBO) | 変分自己符号化器(VAE)等で、計算困難な周辺尤度の下限 $\log p(x) \ge \mathrm{ELBO}$ を導出。 | MCMC(マルコフ連鎖モンテカルロ法)の高コストなサンプリングを最適化問題に置換。 | 生成AIの爆発的進化の火付け役。機械学習への応用理由の筆頭。 |
| 統計検定での出題傾向 | 統計検定1級(数理・応用)で、推定量の一致性やクラメール・ラオの下限の導出過程で頻出。 | 公式暗記だけでは歯が立たず、等号成立条件の深い理解が合否を分ける。 | 受験者の間で最大の得点差がつく選別フィルターとして機能。 |

【実態検証】「現場で使えない数式」というネットの誤解とリアルな機械学習の最前線
プログラミング掲示板やSNS上では時折、「実務で機械学習ライブラリを叩くだけなら、イェンゼンの不等式など知る必要はない」「研究室のペーパーテスト用知識だ」といった懐疑的な声が散見されます。しかし、現役の機械学習エンジニアやAIリサーチャーの現場感覚は真逆です。
大手IT企業で生成モデルの研究開発を行うシニアエンジニアは、技術カンファレンスの場で次のように実情を吐露しています。
「ライブラリの既製ラッパーを使っている間は、数式の裏側を意識しなくても動きます。しかし、既存モデルのボトルネックを解消するために独自の損失関数を設計したり、潜在空間の次元圧縮で勾配消失を防ぐチューニングを施す段になると、変分下限(ELBO)の成立条件を数式レベルで理解していなければ手も足も出ません。不等式の等号が成立する極限状態、すなわち近似事後分布が真の事後分布に一致する条件を肌感覚で把握しているかどうかが、トップティアのエンジニアと単なる作業者の分水嶺になります」
現場で直面する最大の壁は、「直接計算できない対数尤度をいかにして間接的に最大化するか」という課題です。直接最適化が不可能な対数の総和の中にイェンゼンの不等式を差し挟み、扱いやすい「下限値(Lower Bound)」に変換してその下限を押し上げるという戦略は、2026年現在の深層生成モデルや強化学習のポリシー最適化でも根幹を支える定石となっています。
一般に知られていない盲点とネットの誤解|凸と凹の反転による大事故
イェンゼンの不等式を扱う際、初学者のみならず実務者ですら頻繁に陥る危険な罠が存在します。それが「凹関数(concave function)における不等号の向きの逆転」です。
自然対数関数 $\log(x)$ は、機械学習の尤度計算で最も多用される関数ですが、これは「上に凸(凹関数)」です。凸関数の定義と混同したまま機械的に公式を適用し、次のような不等号の反転ミスを犯すケースが後を絶ちません。
誤り: $\log E[X] \le E[\log X]$ (重大な符号ミス)
正解: $\log E[X] \ge E[\log X]$
この符号を逆に認識してしまうと、変分推論において最大化すべき目的関数が「下限」ではなく「上限」になってしまい、最適化のアルゴリズムが根本から破綻します。
もう一つの見落とされがちな盲点が、相加相乗平均との関係における等号成立条件の厳密性です。イェンゼンの不等式において等号が成立するのは、関数が「狭義の凸関数」である場合、確率変数 $X$ が定数(分散が0)であるときに限られます。情報理論で2つの確率分布 $P$ と $Q$ が一致($P = Q$)したときに限りKLダイバージェンスがゼロになるという決定的な性質も、この等号成立条件の厳密性によって担保されているのです。
【プロの結論】イェンゼンの不等式を武器にできる人・挫折する人の判断基準
数理統計や機械学習の学習ロードマップにおいて、イェンゼンの不等式を自分の武器として昇華できる読者と、数式の山に圧倒されて挫折してしまう読者には明確な思考パターンの違いがあります。
【武器にできる人の特徴】
数式を見た瞬間に「放物線の弦とグラフの上下関係」という視覚的イメージが脳裏に浮かぶ人です。さらに、「計算困難な期待値の外側にある関数を、内側に押し込んで計算を可能にするためのツール」という工学的な実用意図を理解している学習者は、変分推論やEMアルゴリズムの複雑な論文を読んでも迷子になりません。
【挫折しやすい人の特徴】
「$E[f(X)]$ と $f(E[X])$ のどちらが大きかったか」を文字の並びだけで丸暗記しようとする人です。関数の凸性(凹凸)の確認を怠り、対数を取った瞬間に不等号を取り違えてしまう学習スタイルでは、統計検定1級の記述問題やオリジナルモデルの実装段階で必ず致命的なエラーを引き起こします。
【イェンゼン の 不等式】に関するよくある質問(FAQ)
Q1:下に凸と上に凸で不等号の向きがいつも分からなくなります。確実な覚え方はありますか?
A1:最もシンプルで身近な具体例として $f(x) = x^2$(下に凸)を脳内シミュレーションするのが一番確実です。確率変数 $X$ が $0$ と $2$ を確率半分ずつでとる場合、$E[X] = 1$ なので $f(E[X]) = 1^2 = 1$ です。一方、$E[f(X)] = (0^2 + 2^2)/2 = 2$ となります。明らかに $1 \le 2$ ですから、「下に凸なら $f(E[X]) \le E[f(X)]$」と即座に再現できます。
Q2:統計検定1級の試験対策では、どのような形で出題される傾向がありますか?
A2:大問の中で「ある推定量の一致性や不偏性を示す過程」の小問として出題される傾向が顕著です。特にコーシー・シュワルツの不等式やイェンゼンの不等式を用いて下限を評価させる誘導問題が多く見られます。結論の不等式を書くだけでは不十分で、関数が連続かつ凸であることの確認や、等号成立条件(分散が0、すなわち確率変数が定数となる場合)を明記できているかが採点基準の大きなウェイトを占めます。
Q3:変分自己符号化器(VAE)の解説で必ず登場する変分下限(ELBO)とどう結びついていますか?
A3:VAEでは、観測データ $x$ の生成確率の対数(対数周辺尤度) $\log p(x)$ を最大化したいと考えます。しかし、潜在変数 $z$ の積分が解析的に解けません。そこで、任意の近似分布 $q(z|x)$ を導入して変形し、対数関数の凹性に対してイェンゼンの不等式を適用することで、「積分記号の内側に対数を入れた下限値(ELBO)」を導出します。この下限値をニューラルネットワークで最適化できる形にしたものがVAEの基本アーキテクチャです。
Q4:多変数(多次元空間)の関数でもイェンゼンの不等式はそのまま成り立ちますか?
A4:そのまま成り立ちます。多変数関数の場合、ヘッセ行列(Hessian)が半正定値であることが「下に凸」の条件となります。多次元確率ベクトル $\mathbf{X}$ に対しても、関数 $f$ が凸関数であれば $f(E[\mathbf{X}]) \le E[f(\mathbf{X})]$ の関係は完全に保持され、多変量ガウス分布を扱う機械学習モデルの最適化でも同様に機能します。
まとめ:今後の動向と失敗しないための判断基準
イェンゼンの不等式は、100年以上前に提示された古典的な純粋数学でありながら、深層学習やベイズ推論が高度化する現代においてその存在感を増し続けています。
複雑極まる多次元データを前にしたとき、直接解けない問題を「扱いやすい下限や上限の評価問題にすり替える」という発想は、あらゆる数理最適化の基本戦略です。不等式の幾何学的イメージを脳内に定着させ、凸関数の性質を的確に見極める視点を身につけること。それこそが、難解なAI理論や数理統計の霧を晴らし、揺るぎない数理的思考力を手に入れるための確かな一歩となります。 (出典: イェンゼン の 不等式(Yahoo!ニュース))
毎日更新されるトレンド情報を分析・発信中。役立つ裏技やおすすめ情報を分かりやすく紹介します。